

Hiệu ứng phân nhóm theo thời gian trong trí nhớ ngắn hạn bằng lời nói và âm nhạc: Miền biểu diễn thứ tự nối tiếp có chung không? Phần 1
Feb 18, 2024
trừu tượng
Câu hỏi về bản chất miền chung và miền cụ thể của các cơ chế trật tự nối tiếp liên quan đến trí nhớ ngắn hạn hiện đang được tranh luận. Nghiên cứu hiện tại nhằm giải quyết câu hỏi này thông qua nghiên cứu các hiệu ứng nhóm thời gian trong các nhiệm vụ trí nhớ ngắn hạn với chất liệu âm nhạc, một lĩnh vực cho đến nay ít được quan tâm.
Là một loại hình nghệ thuật đẹp, âm nhạc không chỉ mang đến cho con người sự thưởng thức nghệ thuật mà còn có tác động tích cực đến sức khỏe thể chất và tinh thần của con người. Nghiên cứu gần đây đã phát hiện ra rằng âm nhạc cũng có thể giúp cải thiện trí nhớ và nâng cao khả năng học tập của con người.
Nhiều nghiên cứu đã chỉ ra rằng âm nhạc có tác động tích cực đến trí nhớ. Bằng cách nghe nhạc, đặc biệt là nhạc cổ điển, bạn có thể thúc đẩy hoạt động của não và cải thiện khả năng nhận thức và tư duy. Điều này là do âm nhạc có thể kích thích sự chú ý của con người và làm cho bộ não của họ tỉnh táo hơn. Khi bạn nghe nhạc, các tế bào thần kinh trong não làm việc với nhau theo một cách rất đặc biệt, giúp bạn ghi nhớ mọi thứ tốt hơn.
Ngoài ra, âm nhạc có thể khiến con người thoải mái hơn, giúp họ tập trung tốt hơn vào việc học và trí nhớ. Đối với những người gặp khó khăn trong việc học và ghi nhớ, nghe nhạc có thể giúp họ dễ dàng đạt được mục tiêu ghi nhớ và học tập hơn. Ngoài ra, một số học sinh cũng nhận thấy rằng việc học tài liệu mới thông qua âm nhạc giúp các em nắm vững kiến thức mới hiệu quả hơn và dễ nhớ hơn.
Vì vậy, mối quan hệ giữa âm nhạc và trí nhớ rất tích cực. Thông qua âm nhạc có nhịp điệu đẹp, chúng ta có thể kích thích chức năng não bộ, cải thiện khả năng nhận thức và kỹ năng tư duy, đồng thời giảm căng thẳng và lo lắng. Khi học và ghi nhớ, chúng ta có thể nâng cao hiệu quả bằng cách lựa chọn âm nhạc phù hợp hoặc sử dụng âm nhạc như một cách thú vị để cải thiện trí nhớ. Tóm lại, việc cải thiện trí nhớ thông qua âm nhạc là một lựa chọn rất tốt, giúp con người học tập và ghi nhớ dễ dàng và vui vẻ hơn. Có thể thấy, chúng ta cần cải thiện trí nhớ, và Cistanche Deserticola có thể cải thiện trí nhớ đáng kể vì Cistanche Deserticola là một dược liệu cổ truyền của Trung Quốc có nhiều tác dụng độc đáo, một trong số đó là cải thiện trí nhớ. Hiệu quả của Cistanche Deserticola đến từ nhiều thành phần hoạt chất có trong nó, bao gồm axit tannic, polysaccharides, flavonoid glycoside, v.v. Những thành phần này có thể tăng cường sức khỏe não bộ thông qua nhiều con đường khác nhau.
Bấm biết 10 cách cải thiện trí nhớ
Mục đích là để xác định liệu mã hóa vị trí - hiện là cách giải thích tốt nhất về hiệu ứng nhóm trong trí nhớ ngắn hạn bằng lời nói - có phải là một cơ chế khả thi để giải thích các hiệu ứng nhóm trong lĩnh vực âm nhạc hay không.
Trong thử nghiệm đầu tiên, những người không phải là nhạc sĩ đã thực hiện tái tạo nối tiếp các 6-chuỗi giai điệu, trong đó một nửa chuỗi được nhóm theo nhóm gồm ba mục và nửa còn lại được trình bày với tốc độ đều đặn.
Mẫu dữ liệu tổng thể gợi ý rằng việc nhóm theo thời gian tác động lên việc tái tạo chuỗi âm có tác dụng tương tự như trong miền lời nói, ngoại trừ các lỗi sắp xếp không được đặc trưng bởi sự gia tăng điển hình của các vị trí xen kẽ.
Mô hình này đã được lặp lại trong hai thí nghiệm bổ sung với tài liệu bằng lời nói, sử dụng cấu trúc nhóm giống như trong thí nghiệm âm nhạc.
Các phát hiện này ủng hộ rằng các miền trí nhớ ngắn hạn bằng lời nói và âm nhạc được đặc trưng bởi các hiệu ứng nhóm theo thời gian tương tự để nhớ lại 6-danh sách mục được nhóm theo ba, nhưng nó cũng gợi ý sự tồn tại của các điều kiện biên để quan sát sự gia tăng các lỗi xen kẽ được dự đoán bởi vị trí các lý thuyết.
Từ khóa
Thứ tự nối tiếp; âm nhạc; bằng lời nói; phân nhóm; miền-chung; trí nhớ làm việc.
Các hoạt động trong cuộc sống hàng ngày như ghi nhớ số điện thoại, thảo luận hoặc chăm chú lắng nghe một bản nhạc đều yêu cầu xử lý thông tin được sắp xếp theo trình tự, mở ra theo thời gian và dựa trên tài nguyên trí nhớ ngắn hạn (STM).
Câu hỏi về việc liệu các cơ chế chủ đề góp phần duy trì các bản ghi nhớ được tổ chức theo thứ tự là theo miền chung hay theo miền cụ thể hiện đang được tranh luận trong tài liệu về STM (Hurlstone và cộng sự, 2014; Jones và cộng sự, 1995; Logie và cộng sự, 2016; Majerus, 2013; Soemer & Saito, 2016; Vandierendonck, 2016).
Nghiên cứu trước đây so sánh các mục bằng lời nói và không gian trực quan theo thứ tự STM đã ủng hộ quan điểm rằng việc trình bày thứ tự nối tiếp trong STM được hỗ trợ bởi các cơ chế chung của miền (để đánh giá, xem Hurlstoneet al., 2014).
Tuy nhiên, mức độ áp dụng giả thuyết miền tổng quát cho STM cho âm nhạc vẫn chưa được giải đáp. Với cấu trúc nhịp điệu và tuần tự vốn có của nó, âm nhạc đại diện cho một ứng cử viên thích hợp để nâng cao hiểu biết của chúng ta về các cơ chế đặt hàng liên quan đến STM, cũng như giải quyết câu hỏi về tính tổng quát của các cơ chế này.
Ngược lại với lĩnh vực ngôn từ, chỉ có một vài mô hình STM âm nhạc (xem Berz, 1995; Ockelford, 2007), không mô hình nào trong số đó cung cấp một giải thích toàn diện về các quy trình chịu trách nhiệm thể hiện trật tự nối tiếp của các chuỗi âm nhạc.
Ví dụ, Ockelford (2007) gợi ý rằng thứ tự nối tiếp được mã hóa trong bộ nhớ làm việc âm nhạc thông qua hoạt động của cơ chế gắn thẻ trong đó mỗi mục đóng vai trò là tín hiệu truy xuất cho mục tiếp theo (để biết thêm chi tiết về khái niệm gắn thẻ, xem Kieraset al., 1999).
Tuy nhiên, theo hiểu biết tốt nhất của chúng tôi, không có bằng chứng thực nghiệm trực tiếp nào cho thấy cơ chế gắn thẻ như vậy đóng vai trò trong việc thể hiện trật tự âm nhạc trongSTM. Hơn nữa, khái niệm gắn thẻ dựa trên một tài khoản chuỗi về biểu diễn thứ tự nối tiếp đã bị thách thức bởi một nghiên cứu gần đây về STM thứ tự nối tiếp cho âm nhạc (xem Gorin và cộng sự, 2018a).
Một số hiệu ứng thứ tự nối tiếp được coi là hiện tượng chuẩn trong miền STM bằng lời nói (Hurlstone và cộng sự, 2014; Lewandowsky & Farrell, 2008) cũng đã được quan sát thấy trong một loạt thử nghiệm STM âm nhạc gần đây (Gorin và cộng sự, 2016, 2018a, 2018b).
Các tác giả giải thích những kết quả này là bằng chứng cho sự tồn tại của các quy trình miền chung để biểu diễn thông tin trật tự nối tiếp trong miền âm nhạc. Cách giải thích này cũng phù hợp với quan điểm cho rằng các hệ thống STM bằng lời nói và âm nhạc bao gồm các quy trình tuần tự chung mặc dù chúng dựa vào các kho biểu diễn khác nhau (Williamson và cộng sự, 2010).
Vì vậy, những kết quả này gợi ý rằng các nguyên tắc sắp xếp cơ bản có tác dụng trong cả hai lĩnh vực. Ngoài ra, họ biện minh cho việc sử dụng các lý thuyết trật tự lời nói như một khuôn khổ để khám phá bản chất của các cơ chế sắp xếp thứ tự trong STM âm nhạc và đánh giá tính tổng quát của các cơ chế này. Giải thích tốt nhất về hiện tượng trật tự chuẩn trong miền lời nói đến từ các mô hình dựa vào mã vị trí để biểu diễn trật tự nối tiếp thông tin (ví dụ, xem Brown và cộng sự, 2000; Burgess & Hitch, 1999; Hartley và cộng sự, 2016; Henson, 1998; Lewandowsky & Farrell, 2008).
Trong các mô hình vị trí, thứ tự nối tiếp được thể hiện bằng sự liên kết giữa các mục và các dấu hiệu độc lập đại diện cho các vị trí. Điểm mạnh chính của lớp mô hình này là khả năng giải thích các hiệu ứng nhóm theo thời gian. Việc nhóm theo thời gian được đặc trưng bằng cách chèn thêm các khoảng dừng giữa một số mục trong quá trình trình bày theo trình tự, tạo ra nhận thức về các nhóm nhỏ mục khác biệt theo thời gian.
Với tài liệu bằng lời nói, những thao tác như vậy dẫn đến các hiện tượng được sao chép tốt, hạn chế các mô hình trật tự nối tiếp của STM (xem Frankish,1985, 1989; Hartley và cộng sự, 2016; Henson, 1996; Hitchet cộng sự, 1996; Maybery và cộng sự, 2002 ; Ng & Maybery, 2002,2005; Ryan, 1969a, 1969b).
Đối với các chuỗi được nhóm lại, lợi thế về cuộc gọi cũng như đường cong sắp xếp chuỗi hình dạng gấp bội thường được quan sát thấy. Sự gia tăng tỷ lệ lỗi xen kẽ hoặc sự dịch chuyển giữa các nhóm của các mục giữ nguyên vị trí nối tiếp ban đầu trong nhóm cũng là đặc điểm của việc nhớ lại các chuỗi được nhóm.
Ví dụ: trong một 6-chuỗi mục bao gồm hai nhóm gồm ba mục, lỗi xen kẽ sẽ làm nhớ lại mục từ Vị trí 2 (tức là Vị trí 2 trong nhóm đầu tiên) tại Vị trí 5 (Vị trí 2 trong nhóm thứ hai) .
Nghiên cứu về hiệu ứng nhóm theo thời gian được đặc biệt quan tâm nhằm giúp xác định bản chất chính xác của việc biểu diễn thứ tự nối tiếp trong STM. Ví dụ: các mô hình dựa vào các mã thứ tự như độ dốc kích hoạt để biểu thị thứ tự tuần tự (ví dụ, xem Farrell & Lewandowsky, 2002; Page & Norris, 1998) có thể đáp ứng các tác động chính gây ra bởi các thao tác nhóm theo thời gian, lợi thế thu hồi và vị trí chuỗi hình vỏ sò đường cong.
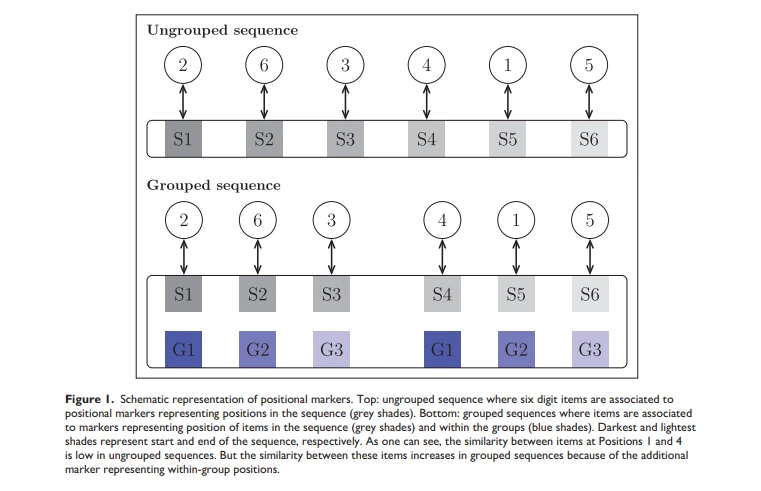
Tuy nhiên, để giải thích cho phạm vi rộng hơn của các hiệu ứng do việc nhóm theo thời gian gây ra (nghĩa là sự gia tăng các lỗi xen kẽ bên cạnh lợi thế thu hồi và sự xuất hiện dạng vỏ sò của đường cong vị trí nối tiếp), cần phải giả định sự tồn tại của mã vị trí. Các mô hình vị trí điều chỉnh sự gia tăng các lỗi xen kẽ bằng cách biểu diễn thứ tự nối tiếp theo thứ bậc. Các mục được liên kết với các điểm đánh dấu vị trí đại diện cho các vị trí trong nhóm, cũng như các điểm đánh dấu đại diện cho vị trí của các nhóm/mục trong chuỗi (xem Brown và cộng sự, 2000; Burgess & Hitch, 1999; Hartley và cộng sự, 2016; Henson, 1998 ).
Việc biểu diễn theo cấp bậc của thứ tự nối tiếp làm cho các mục trong các chuỗi được nhóm trở nên đặc biệt hơn so với các mục không được nhóm, nhờ lợi thế thu hồi và hình dạng gấp bội của đường cong vị trí nối tiếp. Hơn nữa, cách biểu diễn thứ tự theo thứ tự này làm tăng sự giống nhau giữa các mục trong các nhóm khác nhau có chung điểm chung cùng một vị trí trong nhóm, do đó giải thích cho sự gia tăng các lỗi xen kẽ được quan sát thấy trong các chuỗi được nhóm lại (xem các điểm đánh dấu trong Hình 1 để biết ví dụ đồ họa).

Trong lĩnh vực âm nhạc, rất nhiều công việc đã được dành cho việc nghiên cứu các thành phần tâm sinh lý và âm nhạc ảnh hưởng đến cách người nghe người lớn xử lý và duy trì thông tin âm nhạc trong STM (để đánh giá, xem Deutsch, 2013a, 2013b).
Tuy nhiên, người ta biết rất ít về các cơ chế nhận thức liên quan đến việc duy trì thông tin âm nhạc trong thời gian ngắn, đặc biệt là những cơ chế cần thiết để thể hiện và duy trì trật tự của một loạt âm sắc. Ở những người không phải là nhạc sĩ, việc tái cấu trúc trật tự nối tiếp các chuỗi lời nói và âm nhạc được đặc trưng bởi các hiệu ứng trật tự nối tiếp tương tự, cho thấy rằng các nguyên tắc sắp xếp trật tự lời nói có thể được mở rộng sang lĩnh vực âm nhạc (Gorin và cộng sự, 2018a).
Trong một nghiên cứu khác sử dụng nhiệm vụ nhận dạng nối tiếp, các nhà nghiên cứu đã quan sát thấy các hiệu ứng nhóm theo thời gian có thể so sánh được với những tác động thường thấy trong các nhiệm vụ STM bằng lời nói, cho thấy rằng các điểm đánh dấu vị trí được mô tả trong các mô hình STM bằng lời nói của thứ tự nối tiếp có thể đóng một vai trò trong hình thức STM (Gorin và cộng sự, 2016).
Chính xác hơn, các tác giả đã chỉ ra rằng ở những người không phải là nhạc sĩ, tỷ lệ nhận dạng nối tiếp chính xác cho các đầu dò khớp cao hơn đối với các chuỗi được nhóm so với không được nhóm và sự nhận dạng đó là một hàm của vị trí đã áp dụng một hình dạng phản ánh cấu trúc nhóm được sử dụng trong thử nghiệm, sao chép các kết quả trước đó thu được bằng nhạc sĩ (Deutsch, 1980).
Tuy nhiên, kết luận được rút ra bởi Gorin et al. (2018b) bị hạn chế do không thể đánh giá các lỗi xếp nhóm theo thời gian do sử dụng quy trình nhận dạng. Đồng thời, có bằng chứng về sự tồn tại của các lỗi giống như xen kẽ trong các nhiệm vụ sản xuất theo thứ tự nối tiếp đòi hỏi các chuyên gia phải truy xuất và chơi các đoạn trích âm nhạc ngắn trên đàn piano từ trí nhớ (Mathiaset al., 2015).
So với các đoạn trích âm nhạc ngắn hơn, trong đó sự giống nhau giữa các yếu tố có cùng một giọng điệu nhịp điệu (mạnh hoặc yếu) trong chuỗi bị giảm đi, các đoạn trích âm nhạc dài hơn được đặc trưng bởi sự chuyển đổi khoảng cách xa tăng lên giữa các vị trí có cùng giọng điệu nhịp điệu. Điều thú vị là, hiện tượng này có thể được giải thích bằng một mô hình sản xuất chuỗi âm nhạc giả định rằng các sự kiện âm nhạc được sản xuất được trình bày theo thứ bậc (xem Mathias và cộng sự, 2015; Palmer &Pfordresher, 2003; Pfordresher và cộng sự, 2007).
Mô hình này biểu diễn các sự kiện âm nhạc theo vị trí nối tiếp và cường độ trạng thái nhịp điệu của chúng, tương tự như mã hóa thứ bậc của trật tự nối tiếp được đề xuất trong các mô hình vị trí của STM bằng lời nói được mô tả ở trên (xem Brown và cộng sự, 2000; Burgess & Hitch, 1999; Hartley và cộng sự. , 2016; Henson, 1998). Như đã đề cập trước đó, ngày càng có nhiều bằng chứng cho thấy rằng các hiện tượng nối tiếp tiêu chuẩn đặc trưng cho STM lời nói cũng được quan sát thấy trong các nhiệm vụ STM không gian trực quan (để đánh giá, xem Hurlstone và cộng sự, 2014), và ở một mức độ nào đó trong âm nhạc tên miền (Gorin và cộng sự, 2018b).
Bằng chứng này hỗ trợ lý giải đầu tiên rằng việc xử lý thông tin thứ tự nối tiếp được hỗ trợ bởi các quy trình được chia sẻ giữa các miền. Đồng thời, một số tác giả cho rằng sự hiện diện của các hiện tượng trật tự tương tự giữa các miền cũng tương thích với sự tồn tại của các cơ chế dành riêng cho miền, nhưng có những điểm tương đồng về chức năng (ví dụ, xem Logie và cộng sự, 2016; Saito và cộng sự, 2008). .
Thật vậy, việc quan sát hiện tượng trật tự nối tiếp giống nhau trên các miền STM tương thích với cả cơ chế chung cho một miền và với các cơ chế dành riêng cho miền mã hóa thứ tự nối tiếp theo cách tương tự và chỉ tài khoản thứ hai này giả định rằng sự tồn tại của các cơ chế cụ thể theo miền có chức năng tương tự có thể giải thích cho cả hai sự khác biệt và những điểm tương đồng giữa các miền (Logie và cộng sự, 2016).
Một tài khoản khác cho rằng các cơ chế trật tự nối tiếp được chia sẻ qua các phương thức (ví dụ: thính giác hoặc thị giác) chứ không phải các lĩnh vực cụ thể (ví dụ: lời nói, hình ảnh và âm nhạc). Nói cách khác, chúng tôi có thể hình dung rằng cả tài liệu lời nói và âm nhạc đều dựa trên tài nguyên STM thính giác, tài nguyên STM thính giác được củng cố bởi các quy trình chung trong miền thính giác chịu trách nhiệm mã hóa thông tin thứ tự nối tiếp cho cả hai loại tài liệu.
Điều này phù hợp với đề xuất gần đây của Hartleyet al. (2016) đề xuất rằng các nguyên tắc tuần tự giữa các miền chịu trách nhiệm xử lý thông tin đơn hàng nhưng hoạt động song song với các cơ chế dành riêng cho từng miền chịu trách nhiệm về đầu vào nhận thức.

Họ đề xuất một cơ chế điều khiển bằng kích thích chịu trách nhiệm xử lý và mã hóa thông tin trật tự theo trình tự thính giác-lời nói dựa trên hoạt động của các bộ dao động thần kinh theo dõi các biến đổi biên độ của đường bao lời nói ở các khoảng thời gian khác nhau. Điều thú vị là, có ý kiến cho rằng việc mã hóa các đặc điểm nhịp điệu trong cả lời nói và âm nhạc có thể bị chi phối bởi cơ chế dao động điều khiển kích thích tương tự (ví dụ, xem Musacchia và cộng sự, 2014).
Do đó, xem xét bằng chứng về việc xử lý thông tin âm nhạc theo miền cụ thể (Peretz & Coltheart, 2003; Zatorre và cộng sự, 2002), một lý giải chi tiết hơn sẽ là các tính năng của miền cụ thể tương tác với các cơ chế sắp xếp chung của miền (xem Majerus, 2013) .
For more information:1950477648nn@gmail.com


